Agent schreibt – Agent prüft?
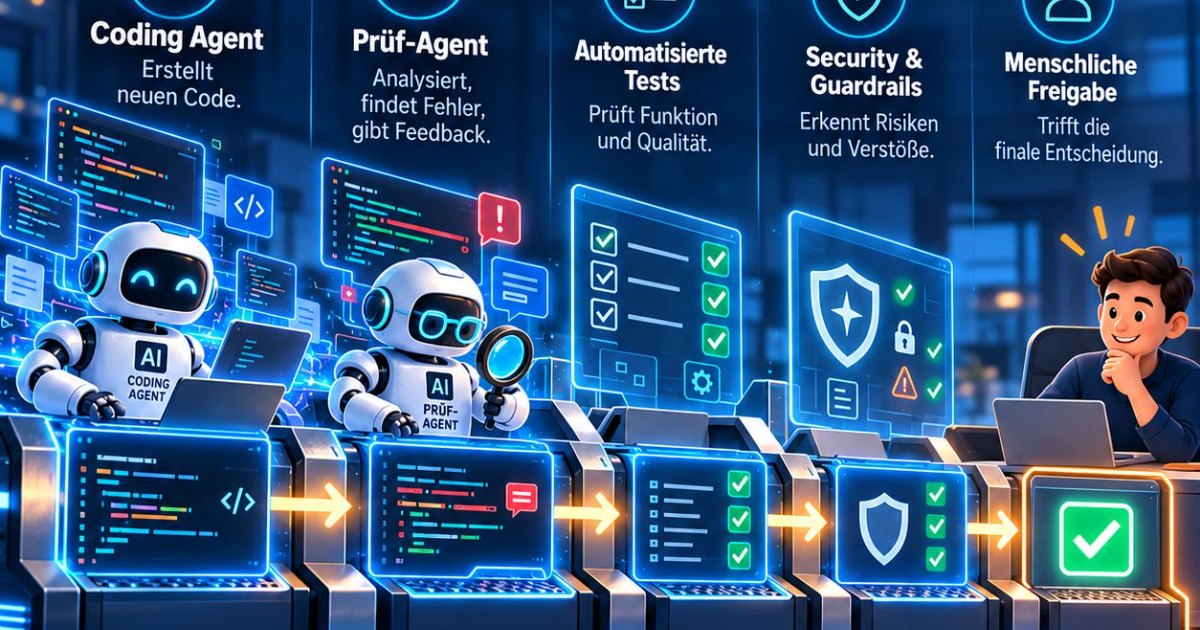
Wenn KI-Agenten immer mehr Code erzeugen, muss auch die Prüfung skalieren. Eine mögliche Antwort sind Agentenketten aus Coding-Agent, Prüf-Agent, automatisierten Tests, Guardrails und menschlicher Freigabe.
- KI-Agenten
- Coding Agents
- Softwareentwicklung
- Softwarequalität
- Cybersecurity
- Softwarearchitektur
- Guardrails
- automatisierte Tests
Agent schreibt – Agent prüft?
KI-Agenten übernehmen zunehmend Aufgaben in der Softwareentwicklung – nicht nur beim Schreiben von Code, sondern auch bei dessen Prüfung.
Google DeepMind beschreibt mit CodeMender einen KI-Agenten, der Sicherheitslücken in bestehendem Code finden, analysieren und beheben soll. Änderungen werden dabei automatisiert validiert, damit Korrekturen keine neuen Fehler oder Regressionen verursachen.
Das zeigt eine interessante Entwicklung:
Wenn KI immer mehr Code erzeugt, kann die Kontrolle darüber kaum ausschliesslich durch Menschen erfolgen. Bei grossen Codebasen wäre das schlicht nicht skalierbar.
Auch OpenAI beschreibt Sicherheitsprüfung zunehmend als eigenen agentischen Prozess. Codex Security analysiert Projekte, identifiziert Schwachstellen und nutzt automatisierte Validierung, um Fehlalarme zu reduzieren und relevante Probleme gezielter herauszufiltern.
Eine mögliche Architektur
Künftig könnten Entwicklungsprozesse deshalb häufiger so aufgebaut sein:
Agent erstellt Code
↓
zweiter Agent überprüft ihn
↓
automatisierte Tests validieren das Verhalten
↓
Regeln und Guardrails prüfen Architektur und Sicherheit
↓
der Mensch entscheidet
Damit entstehen regelrechte Agentenketten innerhalb der Softwareentwicklung.
Unabhängige Prüfung statt Selbstkontrolle
Entscheidend ist dabei ein Punkt:
Ein Agent sollte nicht einfach seinem eigenen Ergebnis vertrauen.
Das gilt genauso wie bei menschlichen Entwicklern: Wer etwas selbst erstellt hat, sollte nicht die einzige Instanz sein, die dessen Qualität bewertet.
Microsoft Research weist ebenfalls darauf hin, dass Coding-Agenten sehr stark auf das reagieren, was tatsächlich geprüft wird. Ein bestandener Test bedeutet deshalb nicht automatisch, dass die ursprüngliche fachliche Aufgabe vollständig erfüllt wurde.
Daraus folgt:
Gute Agentensysteme brauchen mehrere voneinander getrennte Prüfmechanismen.
Dazu gehören:
- automatisierte Tests
- unabhängige Prüf-Agenten
- Architekturregeln
- Security-Checks
- explizite Guardrails
- menschliche Freigaben bei kritischen Entscheidungen
Auch bei aktuellen Agenten-Architekturen wird deshalb zunehmend mit klar definierten Freigabepunkten gearbeitet, an denen Aktionen geprüft oder bei Bedarf an Menschen eskaliert werden.
Der neue Engpass ist die Verifikation
Je schneller wir Software erzeugen können, desto wichtiger wird eine andere Frage:
Wie schnell können wir sie zuverlässig überprüfen?
Der Engpass in der KI-gestützten Softwareentwicklung könnte deshalb künftig weniger das Schreiben von Code sein.
Der eigentliche Engpass wird möglicherweise die verlässliche Verifikation des erzeugten Codes.
Oder anders formuliert:
Mehr Geschwindigkeit bei der Code-Erzeugung braucht mehr unabhängige Kontrolle.
Quellen
- Google DeepMind: Introducing CodeMender: an AI agent for code security
- Google DeepMind: Introducing Gemini 3.5 Flash Cyber
- OpenAI: Codex Security: now in research preview
- Microsoft Research: Building to the Test: Coding Agents Deliver What You Check, Not What You Requested
- Microsoft for Developers: Beiträge zu Guardrails und Freigabepunkten in agentischen Architekturen
Neue Beiträge erscheinen auch im WhatsApp Channel «Softwareentwicklung mit KI-Agenten».
Fragen zum Thema oder ein ähnliches Vorhaben? Schreiben Sie mir über das Kontaktformular.